GUÍA TÉCNICA · RETRIEVAL Y RAG
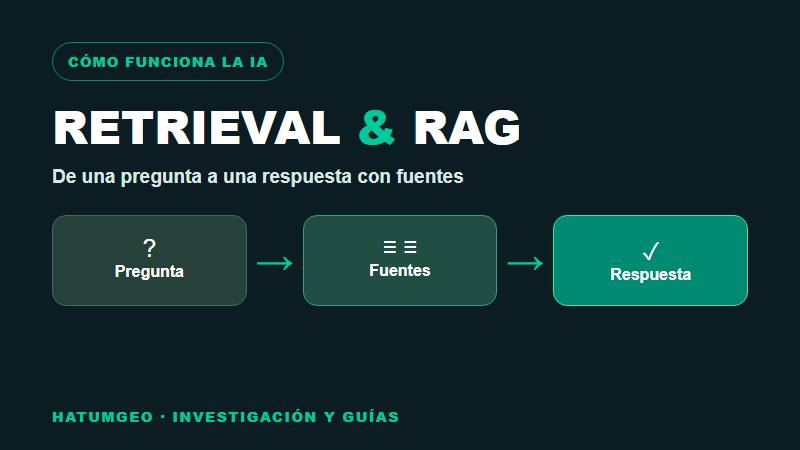
Cuando preguntamos a un asistente de IA por el mejor software de inventarios o por un centro especializado, podemos recibir una respuesta con nombres de empresas, comparaciones y enlaces. La pregunta interesante para GEO no es únicamente si nuestra keyword aparece en un H1: ¿cómo llega información externa hasta la respuesta y cómo podemos hacer que una página resulte más clara y útil?
Para entenderlo necesitamos dos conceptos: retrieval (recuperación de información) y RAG (Retrieval-Augmented Generation, generación aumentada por recuperación). Son ideas relacionadas, pero no idénticas. Retrieval describe la tarea de localizar documentos o pasajes relevantes. RAG es una arquitectura en la que un modelo generativo utiliza información recuperada como contexto para construir una respuesta. No todos los motores implementan públicamente el mismo proceso, y desde fuera no podemos asumir que un resultado observado revele todos sus mecanismos internos.
1. Qué es retrieval: encontrar información relevante antes de responder
Imaginemos una biblioteca digital con miles de documentos. Una persona pregunta: «¿Qué debe tener un ERP para controlar producción e inventarios?». El sistema necesita identificar qué documentos podrían responder, recuperar el contenido disponible y escoger información pertinente. En términos generales, la recuperación de información puede utilizar palabras, representaciones semánticas y otras señales. La técnica exacta depende de la implementación.
En GEO interesa este punto porque la información debe existir en una fuente accesible antes de que alguien pueda recuperarla de allí. Un texto escondido detrás de un inicio de sesión, una página que devuelve un error o un producto descrito de forma ambigua dificultan los análisis y la reutilización de la información. Esto no significa que todos los motores deban rastrear o indexar una web del mismo modo: cada plataforma tiene fuentes, permisos y procesos distintos.
Ejemplo: la ficha de un ERP solo indica «solución empresarial avanzada». Al buscar funciones de control de inventarios, ese fragmento ofrece poca información. En cambio, una sección que explica qué movimientos registra, a qué tipo de organización se dirige y cuáles son las limitaciones del producto permite a un lector evaluar mejor la pertinencia. No afirmamos que añadir esas frases asegure recuperación; es una recomendación de claridad con una hipótesis que puede investigarse.
2. Qué es RAG: utilizar documentos recuperados como contexto
En un sistema RAG representativo, el usuario formula una pregunta, un componente de recuperación busca información y el modelo generativo recibe pasajes relevantes para elaborar la respuesta. La investigación clásica de Patrick Lewis y colaboradores, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020), describe una arquitectura que combina memoria paramétrica de un modelo con memoria no paramétrica recuperada de un índice documental. Se trata de una referencia de investigación sobre RAG, no de una especificación de cómo funcionan por dentro todos los asistentes comerciales. Ver publicación original.
Para explicarlo sin términos de ingeniería, pensemos en un asesor que conoce muchos conceptos pero necesita revisar documentos recientes antes de dar una respuesta. Busca información, selecciona material pertinente y redacta una explicación. Si el sistema expone fuentes, el lector puede abrir algunos documentos utilizados o asociados a la respuesta. Los modelos también pueden equivocarse al resumir, mezclar datos o atribuir afirmaciones; por eso la presencia de una cita no constituye por sí sola una garantía de exactitud.
RAG y búsqueda web no son exactamente lo mismo
RAG es un enfoque técnico general; la búsqueda web es una posible fuente de recuperación. Un sistema puede aplicar RAG sobre documentos privados de una empresa, sobre un índice de conocimiento interno o sobre la web. Además, un buscador con IA puede combinar distintos mecanismos, filtros, índices y modelos. En nuestra comunicación conviene decir «modelo conceptual de recuperación y generación» cuando no disponemos de documentación de una implementación específica.
3. Query fan-out: una pregunta puede generar búsquedas relacionadas
Una pregunta aparentemente sencilla puede contener varias necesidades. «¿Qué ERP me conviene para una empresa industrial de Perú con cinco almacenes?» implica, al menos, capacidades de producción, inventario, presencia comercial en Perú, costes e integración entre sedes. Una estrategia posible consiste en explorar estos subtemas mediante varias consultas antes de sintetizar la respuesta.
Google confirma que AI Overviews y AI Mode pueden usar una técnica de distribución múltiple de consultas —habitualmente llamada query fan-out— para obtener información de diferentes subtemas y fuentes. Es una característica documentada de esas experiencias de Google, no una afirmación universal sobre todos los chatbots. Fuente: Google Search Central.
Ejemplo didáctico — no son consultas internas filtradas de Google:
- «Software ERP para producción industrial».
- «ERP para control de cinco almacenes».
- «Integración inventarios y compras en ERP».
- «Proveedores ERP con operaciones en Perú».
- «Cómo comparar coste de implantación ERP».
El aprendizaje editorial es sencillo: si una sola landing intenta responder superficialmente a todas las preguntas, quizá deje dudas importantes. Podemos crear páginas útiles para necesidades distintas y enlazarlas con criterio. No necesitamos inventar decenas de artículos para cada reformulación posible; lo importante es cubrir subtemas relevantes y reales.
4. Qué es un chunk o fragmento y cuándo conviene revisar los párrafos
Un chunk es una porción de información utilizada en una tarea de procesamiento o recuperación. Puede coincidir con un párrafo, una sección u otra unidad, según el sistema. Desde fuera no conocemos el tamaño exacto de fragmentos que cada plataforma puede utilizar, y no existe una longitud universal en palabras que garantice obtener citas.
Desde el punto de vista editorial podemos aplicar una prueba útil. Leemos una sección de manera independiente y preguntamos: ¿identifica el tema?, ¿responde a una pregunta?, ¿explica condiciones?, ¿incluye evidencia cuando la necesita? Un buen párrafo no debe convertirse en una isla descontextualizada: también necesitamos una estructura coherente para la lectura completa de la página.
Párrafo poco informativo: «Gracias a nuestra tecnología brindamos una respuesta eficiente a todas las necesidades actuales».
Párrafo específico, a modo de ejemplo educativo: «Una orden de producción en un sistema ERP registra las actividades necesarias para fabricar un producto y puede relacionarse con materiales, tiempos y movimientos de inventario, según las funciones implementadas». Es mejor porque explica un concepto en lugar de atribuir beneficios que nadie ha medido.
En HatumGEO evaluamos este tipo de claridad mediante criterios internos como D02 (primer párrafo útil autocontenido), D06 (estructura por secciones), D07 (respuestas autocontenidas) y E03 (afirmaciones respaldadas). Son pautas de revisión; no factores oficiales publicados por motores generativos.
5. Recuperación, mención y cita: tres resultados diferentes
Después de una consulta podemos observar que una marca sea mencionada, recomendada o respaldada por una fuente enlazada. Las tres situaciones son distintas. Un asistente puede recomendar una marca sin mostrar una URL de su dominio, o citar una guía sin incluir el nombre de su empresa en el texto principal. También puede recuperar información y decidir no usarla en la respuesta final, aunque no siempre podamos observar esos pasos desde la interfaz.
Para medirlas necesitamos definiciones precisas:
| Indicador observado | Pregunta que resuelve | Qué no demuestra |
|---|---|---|
| Mención de marca | ¿Apareció su nombre en una respuesta válida? | Que haya sido recomendada o citada |
| Recomendación | ¿La respuesta propuso la marca como una alternativa? | Que exista un enlace a su web |
| Cita de dominio | ¿La respuesta mostró una URL identificable del dominio? | Que el motor usara exclusivamente esa página |
| Cobertura de medición | ¿Cuántas respuestas permitieron medir cada indicador? | Ausencia de resultados cuando no hay datos |
Debemos registrar motor, interfaz, consulta, fecha, país cuando corresponda y evidencia accesible. Si una plataforma no entrega URLs comprobables, el dato de citación queda como no medible. La ausencia de medición no se registra como una cita fallida.
6. Ejercicio: mejoramos una página para que sea útil, después medimos
Supongamos que analizamos una guía de «costes de ERP industrial». Primero verificamos el rastreo y la indexabilidad. Después analizamos si el texto contiene información clara: qué componentes pueden modificar un presupuesto, por qué los precios dependen del alcance y qué datos debería solicitar el cliente para comparar propuestas. Buscamos fuentes que respalden afirmaciones sobre normativas o prácticas sectoriales y revisamos si los enlaces internos llevan a fichas relevantes.
El siguiente paso no es declarar «listo, ya es citable», sino seleccionar un grupo de preguntas representativas, registrar resultados de distintos motores y comparar mediciones repetidas. Una prueba antes/después puede revelar cambios, pero también puede verse afectada por ajustes de modelo, nuevas fuentes o diferencias de respuesta. Si queremos atribuir un efecto a una intervención, necesitaremos controles, trazabilidad y suficientes observaciones.
Este procedimiento conecta el SEO técnico con GEO sin inventar una relación causa-efecto. Una página mejor documentada puede ser más útil y resultar más verificable, pero las citas siempre deben medirse, no suponerse. Para explicar la parte editorial, enlazamos nuestra guía de contenido citable; para la parte de comprobación, la metodología de medición de visibilidad IA.
7. Errores comunes cuando se habla de retrieval y GEO
Error 1: pensar que todos los motores leen la web en tiempo real. No conocemos ni controlamos todos los mecanismos de actualización, búsqueda y selección; debemos verificar lo que la plataforma documenta.
Error 2: afirmar que un párrafo de determinada longitud garantiza una cita. La claridad es buena práctica editorial; una cantidad fija de caracteres o palabras no es un requisito universal confirmado.
Error 3: confundir posición SEO y cita de IA. Una posición media en Search Console describe un resultado orgánico agregado; no constituye una medida directa de qué fuentes usa un asistente.
Error 4: citar un estudio sin reproducir su contexto. El trabajo de Aggarwal y colaboradores sobre GEO analizó intervenciones y métricas concretas bajo condiciones experimentales. Sus resultados no equivalen a una promesa de crecimiento para todas las webs. Estudio GEO.
Error 5: publicar cien guías sin información nueva. Google recomienda contenido útil, original y dirigido a personas; ampliar el sitio sin aportar respuestas mejores no sustituye la experiencia ni la evidencia. Google: contenido fiable.
Preguntas frecuentes
¿Retrieval es lo mismo que entrenamiento de una IA?
No. Retrieval consiste en buscar información disponible para un proceso de respuesta o análisis. Entrenamiento se refiere al desarrollo y ajuste de modelos mediante datos. OpenAI, por ejemplo, diferencia el rastreador de búsqueda OAI-SearchBot y el relacionado con entrenamiento GPTBot.
¿RAG garantiza que un modelo no invente datos?
No. Incorporar documentos recuperados puede ofrecer contexto útil, pero el modelo todavía puede interpretar mal una fuente o realizar una atribución incorrecta. Las respuestas importantes requieren verificación.
¿Debemos fragmentar nuestras páginas en párrafos muy cortos?
No existe esa obligación general. Debemos escribir secciones claras, con contexto suficiente y una arquitectura útil para personas. La división en fragmentos es un mecanismo técnico cuya implementación depende del sistema de recuperación.
¿Puedo saber si ChatGPT utilizó exactamente un párrafo de mi web?
No siempre. Una cita visible puede mostrar una URL, pero generalmente no expone toda la secuencia interna de recuperación, selección y generación. Para afirmaciones exactas necesitamos evidencia de la interfaz, herramientas permitidas y un protocolo documentado.
Conclusión
Retrieval responde a «¿dónde encuentro información pertinente?»; RAG describe un enfoque para usar información recuperada durante la generación. Query fan-out añade la posibilidad de explorar varias subpreguntas en determinadas experiencias de búsqueda. Para GEO, el trabajo útil es producir información accesible, precisa, verificable y bien relacionada, y después observar cómo aparece en respuestas reales. Eso aporta más que optimizar para supuestas reglas secretas.
Continúa con fundamentos SEO para GEO , factores GEO, contenido citable y fuentes en motores de IA.
Fuentes y referencias
- Lewis et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. Fundamento técnico general de RAG.
- Google Search Central. Funciones de IA y tu sitio web. Documenta prácticas SEO y uso posible de query fan-out en AI Overviews/AI Mode.
- OpenAI. Overview of OpenAI Crawlers. Distinción entre bots y propósitos.
- Aggarwal et al. (2023–2024). GEO: Generative Engine Optimization. Evidencia experimental contextualizada.
- HatumGEO. Catálogo propio D02/D06/D07/E03 y metodología de seguimiento. Son criterios internos.
HatumGEO · Guía editorial sobre SEO, recuperación y visibilidad en motores de IA.

2 comentarios